
安装
在 DeepSeek Harness 里通过 dsh-market 安装
dsh plugin --profile web add dshmarket
或使用命令行
dsh plugin --profile web add dsh-resume-screening
装任何插件都等于在你的机器上跑第三方代码,权限和你本人一样大——能读你的文件、用你的凭据、访问网络。请先审阅源码,并尽量锁定 commit(github:owner/repo#sha)。
截图
README
DeepSeek Harness 简历筛选插件:面向 HR 的批量简历入库 + 自动化初筛工具。单个简历库可管理 10 万份以内的简历(docx / pdf / xlsx / xls / md / txt),统一建档入库后用自然语言下达筛选条件:先靠数据库精准粗筛,再对少数入围者做 LLM 精判,秒级返回按适配度排序的候选人名单。
核心能力
① 简历批量入库与统一管理
- 支持 docx / pdf / xlsx / xls / md / txt,自动转换为统一格式的 Markdown 归档;
- 按文件内容哈希自动去重,重复投递不重复建档;
- 每条简历记录入库时间与源文件修改时间,方便识别"收进来太久"的简历。
② 结构化建档(一次入库,永久复用)
- 入库即抽取并写入结构化档案:
- 硬性字段(规则抽取,确定性高):学历 / 性别 / 年龄 / 工作年限 / 学校 / 专业;
- 细粒度技能(LLM 兜底抽取):如 Java、Spring Boot、Vue 3、MySQL…;
- 粗颗粒类别(规则 + LLM 兜底):技能类别(计算机 / 财务 / 金融 / 管理 / 外贸…)、经验方向(编程开发 / 财务会计 / 数据分析…),供后续快速粗筛;
- 抽取遵循"规则优先(快、免费、可复现)→ LLM 兜底(低置信 / 语义字段,JSON 强约束防幻觉)",全部标签带置信度与来源。
③ 两段式智能筛选
- 第一段 · 规则粗筛:在库内按「必选硬条件 + 可选加分加权」匹配,毫秒级缩小范围(如:必须男、本科及以上、会 JAVA,最好 2 年工作经验加分);
- 第二段 · LLM 精判:仅对粗筛入围者逐份读原文判"适配度",输出 0-100 分、结论档位(强烈推荐 / 可面试 / 保留 / 不推荐)、命中技能、缺口、硬字段复核;
- 一次筛选的规则分与 LLM 分都会落库,同一个岗位条件可反复复用。
④ 增量自动入库
resume_screen支持传入简历文件夹:先把该文件夹里未入库的新简历自动入库(去重 → 建档 → 打标 → 记录时间),再对全库整体筛选。用户拿任何一批新简历发起筛选都不会漏。
⑤ 岗位条件可复用
- 用自然语言把招聘要求保存为「岗位」(必选 / 加分 + 算子 + 权重),例如「JAVA 工程师岗」,后续有新简历即可一键按同一套标准复筛。
⑥ 工程底座
- Markdown 归档为真相源,SQLite 为筛选索引(多值标签 / 加权排序 / 多条件 AND),索引可随时从归档全量重建;
- 批量处理带状态机 + 断点续跑 + 幂等去重;
- LLM 调用复用 DSH 当前对话模型(宿主标准流式接口
ctx.llm.stream),结构化抽取/精判请求显式关闭思维链以控制成本与延迟。
对比:用本插件 vs 直接把简历丢给 LLM
| 维度 | 直接把简历丢给 LLM | 本插件 |
|---|---|---|
| 规模化 | 上下文有限,数百份即溢出或质量下降 | 简历提前入库建档,筛选在库内完成,最高支持 10 万份量级 |
| 成本 | 每次筛选全量重读全部简历,费用随数量线性膨胀 | 只有粗筛入围的少数人才调用 LLM |
| 硬条件准确度 | 依赖模型"读",标准不稳定、可能看漏 | 数据库字段过滤,确定性高、可复现 |
| 增量简历 | 记不住历史,需全量重筛 | 自动入库 + 自动去重,增量筛选 |
| 结果追溯 | 无 | 分数 / 理由 / 入库时间全部留档,可导出 CSV |
核心优势:快(库内粗筛秒级)、省(LLM 只精判少数人)、准(硬条件查档案,不会双标不漏人)、全(新简历永不漏、重复自动去重、入库时间可考)。
快速开始(对话)
# 1. 初始化简历库 + 收简历
resume_init
resume_ingest folderPath="D:\简历库\0908简历"

# 2. 建立岗位要求(自然语言结构化)
resume_define_rule 岗位名="JAVA工程师岗"
   必选: gender=男;education in 本科/硕士/博士;skill contains java
   加分: experience_years>=2 (+15)

# 3. 自动入库 + 初筛 + LLM 精判(一次完成)
resume_screen reqId=2 folderPath="D:\简历库\0908简历" llm=true

# 4. 导出结果
resume_export reqId=2 outPath="D:\简历库\结果.csv"
筛选运算符口径
| 运算符 | 口径 |
|---|---|
= / != |
去空白 + 大小写不敏感比较;数值等价("5" == 5) |
in |
逗号分隔(中英文逗号都认)任一相等 |
>= <= > < |
数值比较;值不是数字时退化为相等比较 |
contains |
大小写不敏感 + 拉丁词整词边界:java 命中 Java、Java 开发,不命中 JavaScript;c++ / .net / node.js / 中文词按子串匹配 |
contains 的整词边界意味着 sql 不再命中 MySQL —— 要匹配这种写法请把关键词写全(如 mysql)。
多值标签(skill 等)只要任意一个值命中即算命中。
工具一览
| 工具 | 作用 |
|---|---|
resume_init |
初始化简历库(归档目录 + SQLite + 标签字典) |
resume_ingest |
扫描文件夹收简历,内容哈希去重,入库待处理 |
resume_process |
批量 转换 → 规则抽取 → LLM 兜底 → 归档 + 入库 |
resume_status |
查看库内简历处理状态分布 |
resume_define_rule / resume_list_rules |
保存 / 查看岗位筛选条件 |
resume_screen |
执行筛选;llm=true 追加精判;folderPath 触发自动入库 |
resume_export |
导出筛选结果 CSV(含入库时间 / 源文件时间) |
resume_rebuild |
从归档 Markdown 全量重建索引 |
斜杠命令:/resume_screen(host 直跑,不经模型)。
工作原理
| 层 | 角色 |
|---|---|
| Markdown 归档(真相源) | 每份简历一篇 .md,含结构化属性与原文,可读、可迁移、永不丢 |
| SQLite(筛选索引) | 派生索引:候选人 / 标签 / 标签值 / 岗位 / 条件 / 筛选结果,为筛选而生,可随时全量重建 |
| 筛选引擎(规则层) | 必选硬过滤 → 可选加分加权排序,纯函数、可复现 |
| LLM 精判层 | 对入围者读原文判适配度,输出结构化评分与理由 |
标签体系
- 硬性字段(列存):学历、性别、年龄、工作年限、学校、专业
- 语义 / 分类标签(多值标签表):
skill(细粒度技能)、skill_category(技能类别)、experience_direction(经验方向)、project_management(项目管理经验) - 时间字段:
ingested_at(入库时间)、source_mtime(源文件修改时间) - 标签字典可在 Web 面板增改(键 / 显示名 / 类型 / 说明 / 是否多值);
skill_category、experience_direction为核心粗分类维度,默认始终注入,不受历史持久化设置遮蔽。
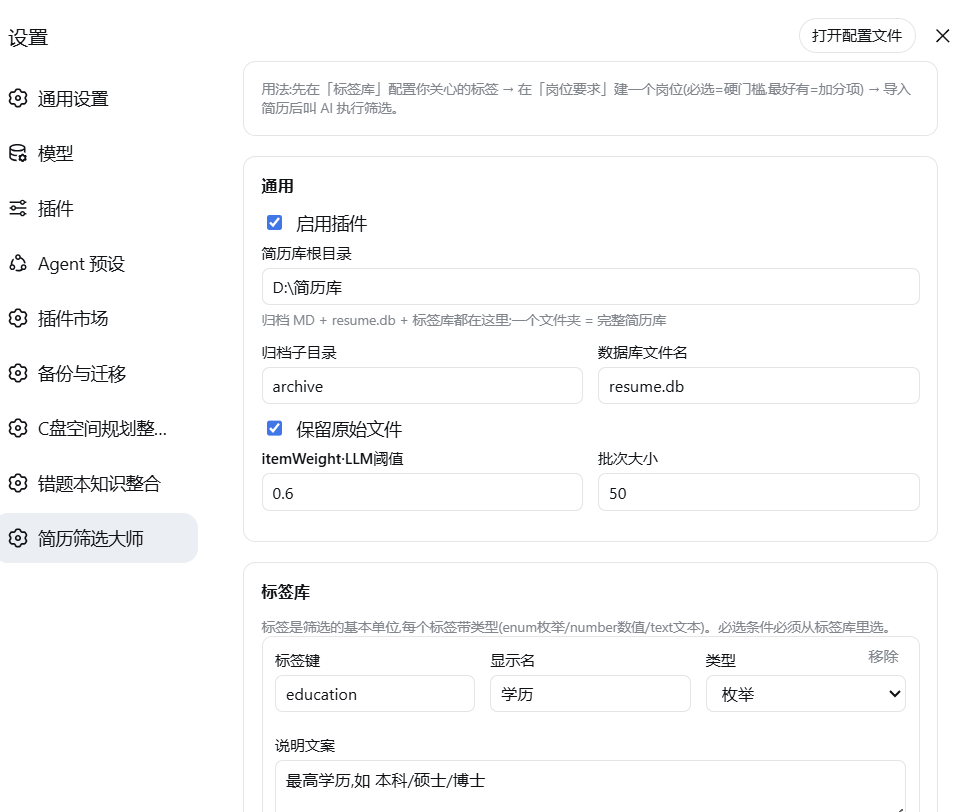
Web 设置面板
参考 dsh-study-notebook 的 settings.section 模式:
- 通用:简历库根目录、归档子目录、是否保留原文件、LLM 开关与阈值、批次大小
- 标签库:增改标签定义
- 岗位要求:一岗位一组条件(标签 + 算子 + 阈值 + 必选/可选 + 权重 + 说明文案)
环境要求
- DSH 0.1.7 ~ 0.2.x —— 设置面板依赖 0.1.7 的
configForms契约。旧版 DSH 上 host 功能(入库 / 建档 / 筛选 / 导出)照常可用,只是设置面板不会出现。 - 0.2 已实测可用:本机在
0.2.0-rc.1上完整跑通(含浏览器端设置页);peerDependencies上界已从<0.2.0-0抬到<0.3.0-0。 - Node.js
^22或>=24(用到内置node:sqlite)
配置
三层来源,后者覆盖前者:
- 内置默认值 ——
config.mjs的DEFAULT_CONFIG ~/.dsh-resume-screening/config.json—— 本地配置文件,仍被读取- DSH profile 配置 ——
cordis.patch.yml里本条目insert[].config,优先级最高;Web 设置面板的写入落在这里
0.1.7 契约变更:旧的
settings.register(...)+settings.yaml通道已作废(DSH 0.1.7 移除了dsh-settings-file)。 现在插件具名导出Config(schemastery schema)供 DSH 投影成设置表单,每个可写字段标.volatile()表示「能现场改」。 依赖 schemastery>= 3.18.4(才有.volatile()),并直接依赖@deepseek-ai/cosmokit(判定/解包 Volatile 盒)。⚠️ 两个必须知道的 0.1.7 事实(都是 2026-09-26 实测,0.1.1 在这两条上都栽过):
.volatile()字段的解析值是「Volatile 盒」不是纯值 ——apply(ctx, config)与settings.describe()给出的config.libraryRoot等是{get()}冻结对象,必须.get()解包, 否则path.join()会抛The "path" argument must be of type string ... Received an instance of Object(症状:面板正常,但所有工具一调就崩)。宿主自己的插件也这么解(如dsh-agent-default-model)。- 写入设置不会让插件重新
apply—— 面板保存只落盘 + 更新宿主镜像,插件内存里的配置快照不会自动刷新。 所以插件必须在每个入口重读settings.describe();本插件统一收口在currentConfig()。
开发与测试
npm run check   # 8 个文件语法校验
npm test        # 回归测试:复刻宿主的「Volatile 盒」配置,真调 resume_init / resume_status,
                # 并验证「改设置后不重启即生效」
test/runtime.mock.mjs 不连宿主、不联网:用插件自己的 Config 解析出宿主会交付的那份配置,
再真调工具。改了配置读取链路后必跑 —— 这类 bug 只验设置面板是发现不了的。
依赖
@deepseek-ai/dsh-tools(peer,宿主提供)@deepseek-ai/schemastery、@deepseek-ai/cosmokit、mammoth(docx)、pdfjs-dist(pdf)、xlsx(excel)- 存储:
node:sqlite(Node 22+,零外部原生依赖) - LLM:复用宿主
dsh-llm(ctx.llm.stream标准流式接口,非自建通道)
License
MIT
评论
评论存放在 GitHub Discussions。用 GitHub 账号登录后可发表评论或点表情。